AIの学習データとは?ChatGPTの回答が作られる仕組みを初心者向けに解説
「ChatGPTは、どうしていろいろな質問に答えられるの?」
生成AIを使っていると、一度はこのような疑問を持つのではないでしょうか。
結論から言うと、生成AIは大量のデータから言葉や画像などのパターンを学習し、その学習結果を使って回答を生成しています。
ただし、「インターネットの記事を丸ごと覚えていて、質問されるたびに学習データの中を検索している」という仕組みではありません。
AIの開発では、文章・画像・音声・コードなどの大量のデータからパターンや関係性を学び、その結果がAIモデル内部の数値的なパラメータとして反映されます。
そしてユーザーから質問を受けると、その学習結果や入力された文章、場合によっては検索・外部ツールなどから得られた情報を使って回答を作ります。
AIの学習データとは、AIが言語や画像などのパターンを学ぶために使われる情報です。ただし、AIは回答するたびに学習データそのものを検索して文章をコピーしているわけではありません。学習によって形成されたモデルと、現在与えられている情報を使って回答を生成します。
この記事では、AI初心者の方でも理解できるように、
- AIの学習データとは何か
- どのようなデータが使われるのか
- AIがデータから学習する仕組み
- ChatGPTなどが回答を作る流れ
- 検索エンジンとの違い
- 個人情報・著作権・ハルシネーションなどの注意点
まで順番に解説します。
AIの学習データとは?
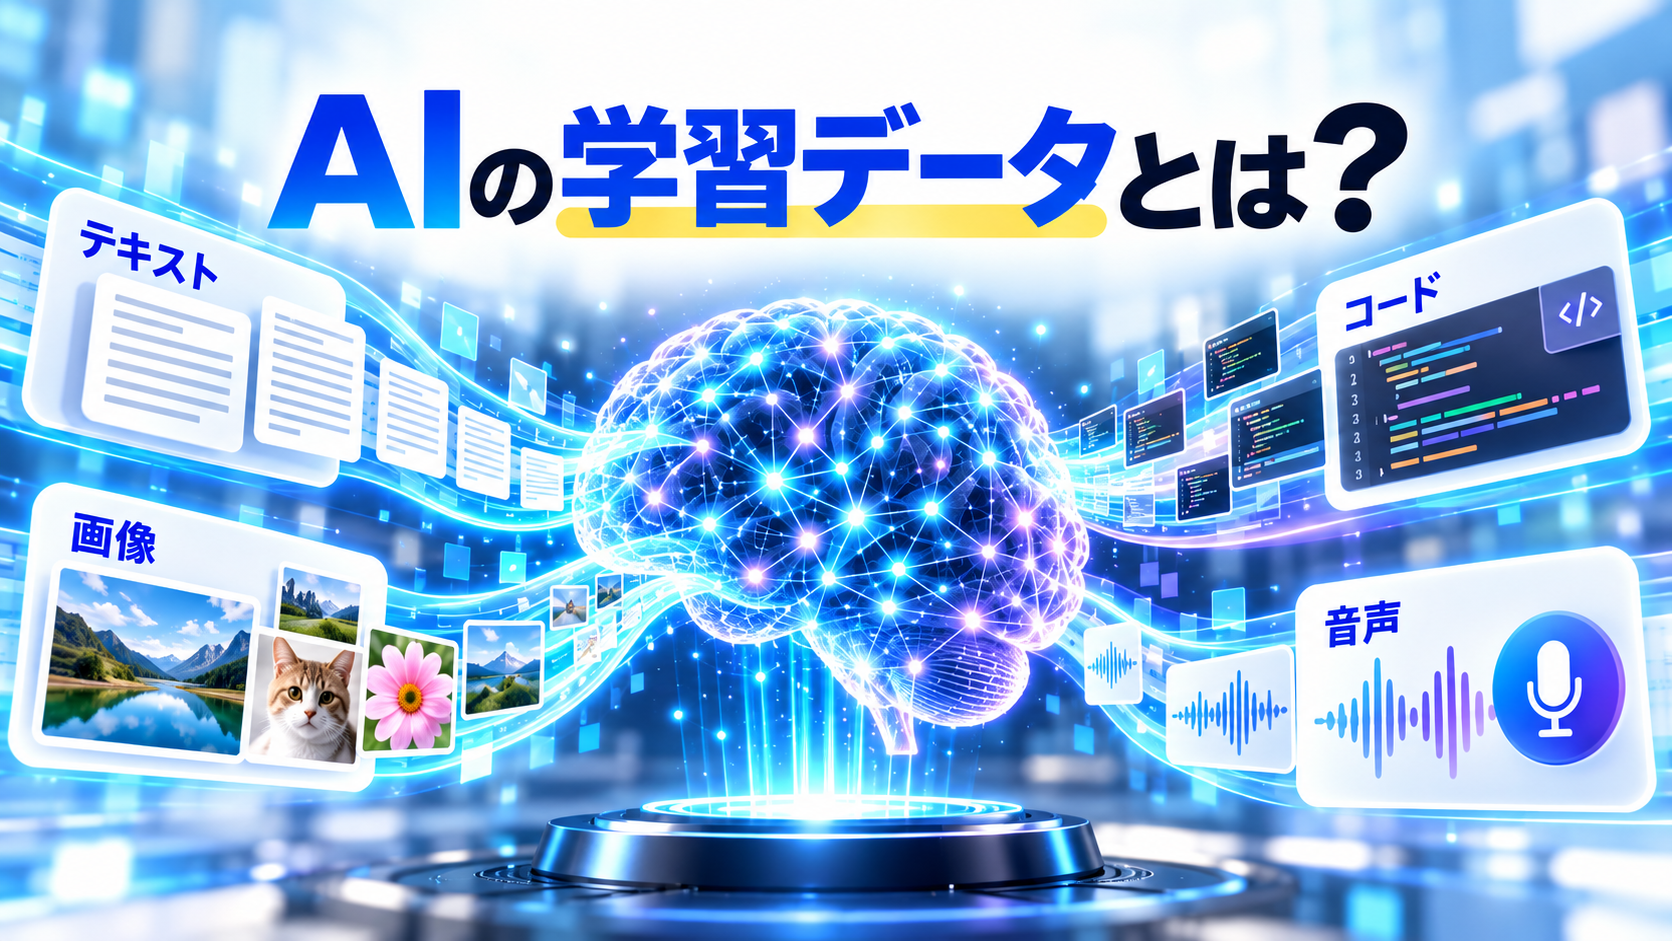
AIの学習データとは、AIモデルがパターンや関係性を学習するために使われるデータのことです。
文章を扱うAIなら大量のテキスト、画像を扱うAIなら画像、音声を扱うAIなら音声といったように、目的に応じてさまざまなデータが利用されます。
現在の生成AIはテキストだけを扱うものとは限りません。文章・画像・音声・動画など複数の種類の情報を扱える「マルチモーダルAI」も一般的になっています。
代表的な学習データの種類
| データの種類 | 具体例 | 主な用途 |
|---|---|---|
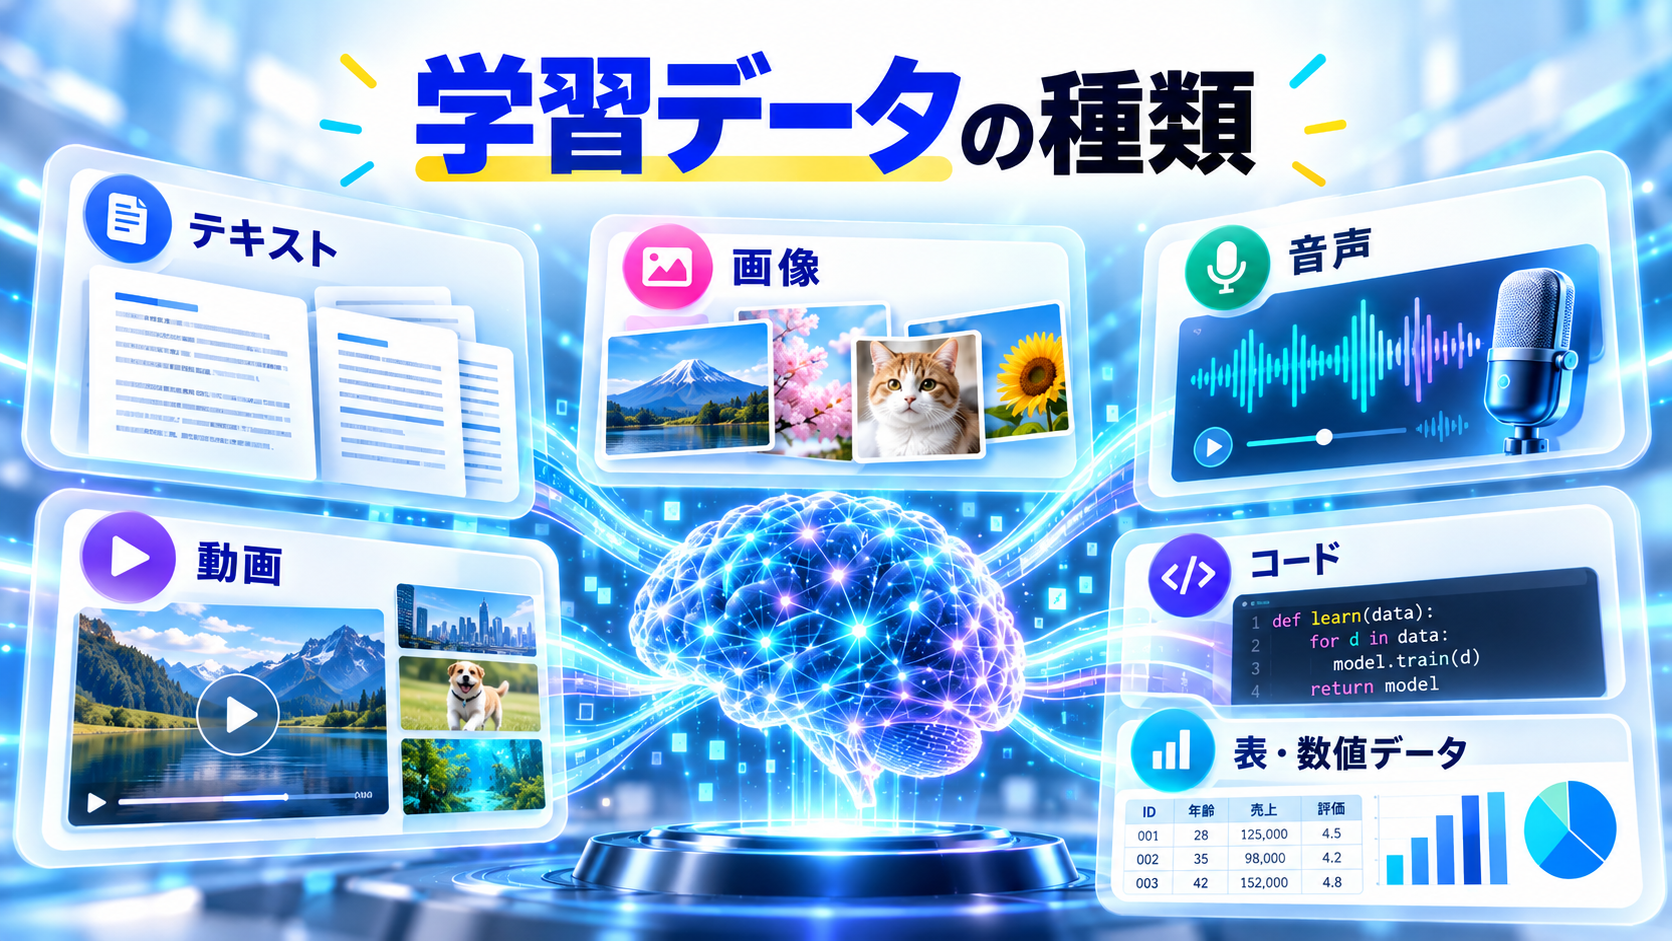
| テキスト | Webページ、書籍、文書、会話、コードなど | 文章生成、翻訳、要約、質問応答 |
| 画像 | 写真、イラスト、図、グラフなど | 画像認識、画像生成、画像分析 |
| 音声 | 人の声、環境音、音楽など | 音声認識、音声生成、文字起こし |
| 動画 | 映像と音声を含む動画データ | 動画理解、動画生成、行動解析 |
| プログラムコード | さまざまなプログラミング言語のコード | コード生成、説明、補完、デバッグ支援 |
| 人間からのフィードバック | 回答評価、専門家による確認、改善用データなど | 回答品質、安全性、指示への従いやすさの改善 |
ChatGPTなどの生成AIは、どんなデータを学習している?
生成AIの学習データの内容や取得方法は、AIを開発している会社やモデルによって異なります。
そのため、「すべての生成AIがインターネット全体を学習している」と考えるのは正確ではありません。
例えばAIモデルの開発では、一般的に次のような種類の情報が利用される場合があります。
- インターネット上で公開されている情報
- 利用許諾を得たデータ
- 企業や研究機関が保有・作成したデータ
- 人間のトレーナーや専門家が作成したデータ
- ユーザーが提供した情報のうち、利用条件や設定上モデル改善に利用できるもの
- AIなどを使って作成した合成データ
具体的にどのデータが使われるか、ユーザーの入力内容がモデル改善に使われるかどうかは、サービス・契約・設定によって異なります。利用しているAIサービスの最新のプライバシーポリシーやデータ利用設定を確認してください。
AIは学習データを丸暗記しているの?
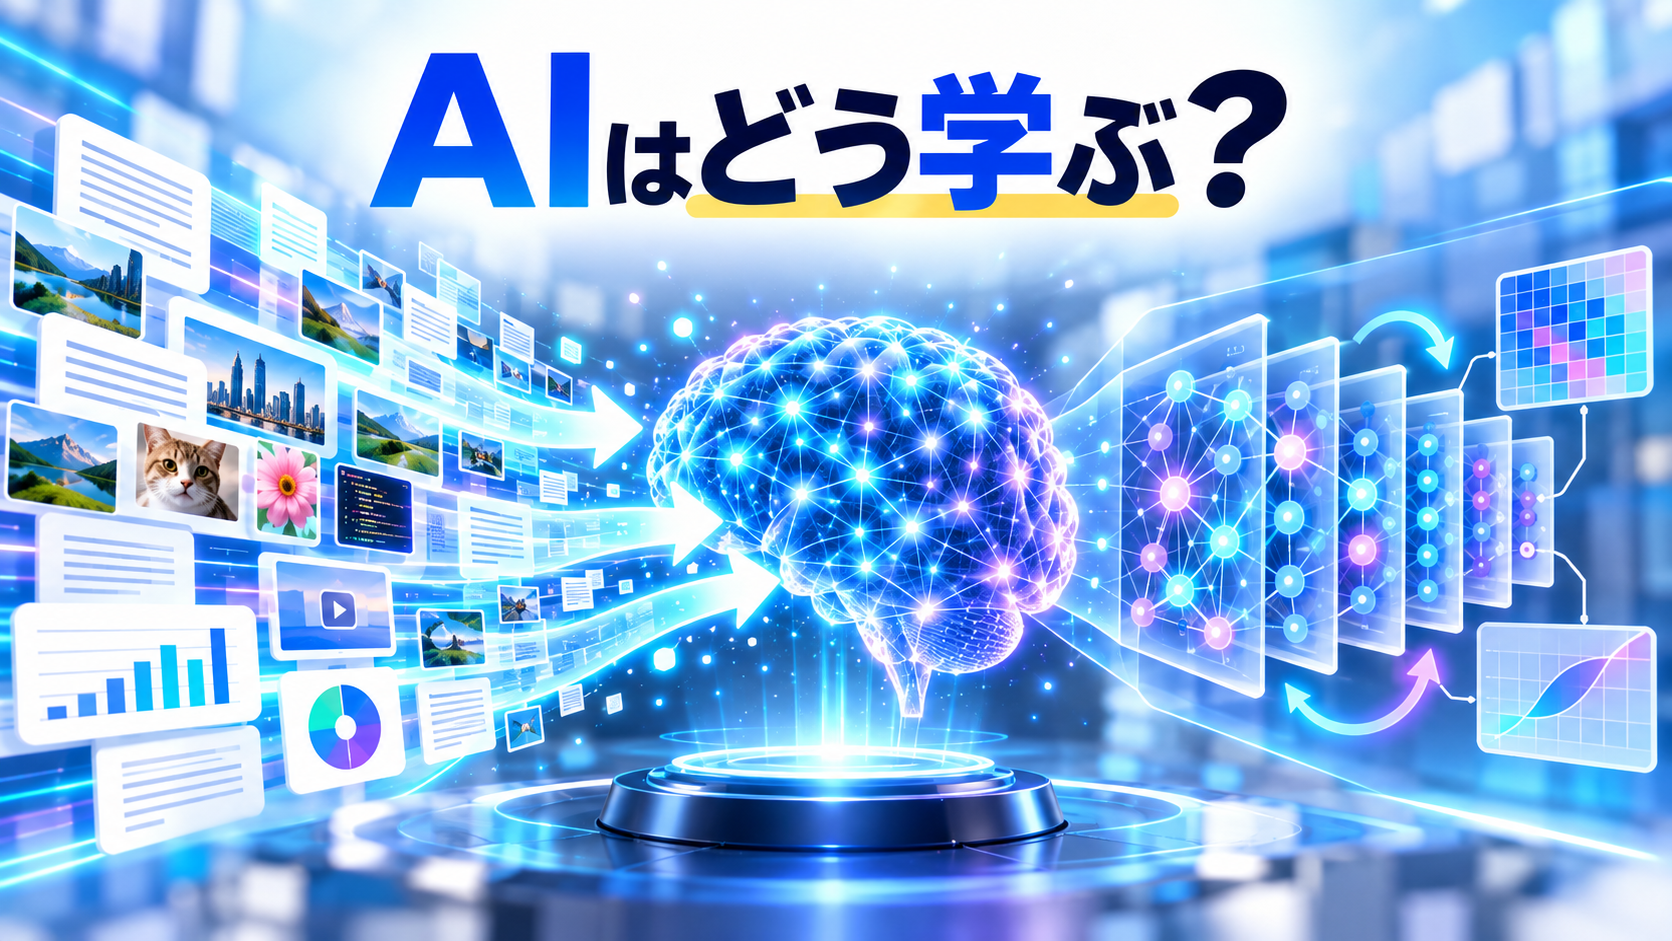
基本的には、学習データをそのまま巨大なデータベースとして保存し、毎回そこから文章を取り出して回答しているわけではありません。
AIモデルは学習によって、データに含まれる言葉の関係、文章構造、概念同士の関係などを数値的なパターンとしてモデル内部に反映します。
これを初心者向けにたとえるなら、「本を大量に読んだ人が、本のページを毎回答えとしてコピーするのではなく、学んだ知識や考え方を使って自分の言葉で説明する」状態に近いイメージです。
もちろんAIと人間の学習方法は同じではありません。しかし、「元データを毎回検索してコピーする仕組みではない」という点を理解するには分かりやすいたとえです。
AIが学習データから学ぶ仕組み
生成AIの学習は、大きく「事前学習」と「学習後の調整」に分けて考えると理解しやすくなります。
1.事前学習で大量のパターンを学ぶ
大規模言語モデル(LLM:Large Language Model)では、大量の文章などを使って言語のパターンを学習します。
代表的な方法の一つが、文章の続きを予測する学習です。
例えば、
「日本の首都は__」
という文章があった場合、その後にどのような情報が続きやすいのかを予測します。
このような予測を非常に多く繰り返すことで、
- 単語同士の関係
- 文章構造
- 文脈
- 概念同士の関連性
- さまざまな分野の知識パターン
などをモデル内部に学習していきます。
2.学習結果がモデルのパラメータに反映される
AIが学習した内容は、そのまま文章として保存されるわけではありません。
ニューラルネットワークと呼ばれる仕組みの中に存在する大量の「パラメータ」と呼ばれる数値が調整されます。
簡単に言えば、学習とは「大量のデータを読み込んで保存する作業」ではなく、「データのパターンを使ってモデル内部の数値を調整していく作業」です。
3.学習後に回答品質や安全性を調整する
事前学習だけでは、AIが必ずしもユーザーの指示に分かりやすく回答できるとは限りません。
そこで開発者によるデータ、人間からのフィードバック、評価データなどを利用し、
- ユーザーの指示に適切に答える
- 分かりやすい文章を作る
- 危険な回答を抑える
- 事実性や推論能力を高める
といった方向へモデルを調整します。
この段階は一般に「ポストトレーニング(事後学習)」などと呼ばれます。
ChatGPTは質問されると、どうやって回答を作る?
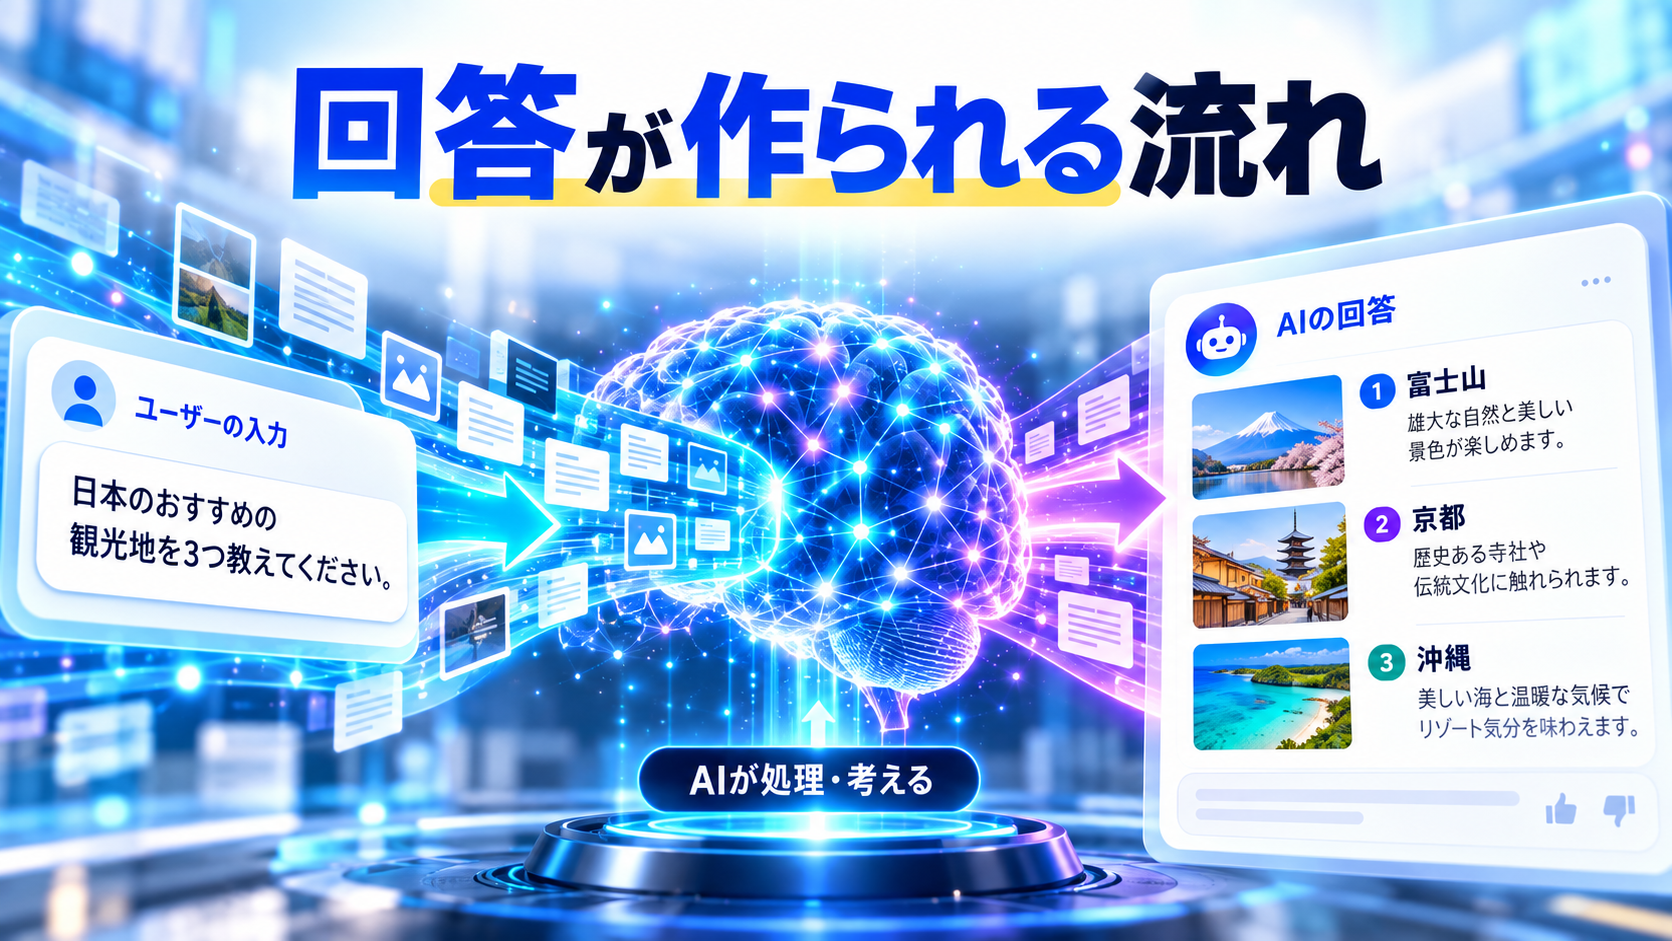
ChatGPTなどの生成AIは、ユーザーから入力された文章とモデルが学習したパターンをもとに、回答として適切な続きを予測しながら文章を生成します。
ただし現在のAIシステムは、単純に「学習データだけ」を使って回答しているとは限りません。
サービスや機能によっては、
- 現在の会話内容
- アップロードされたファイル
- Web検索結果
- 外部データベース
- 接続されたサービス
- 計算・コード実行などのツール
を利用できる場合があります。
ステップ1:ユーザーが質問を入力する
例えば、
「AIの学習データとは何ですか?高校生にも分かるように説明してください」
と入力したとします。
AIは「AIの学習データについて知りたい」「難しい専門用語を避けた説明が求められている」といった入力内容を踏まえて回答を生成します。
ステップ2:入力内容をトークンとして処理する
大規模言語モデルは文章を、そのまま人間と同じ方法で読んでいるわけではありません。
入力された文章を「トークン」と呼ばれる処理単位に分け、数値として扱います。
トークンは単語と完全に同じとは限らず、単語の一部や記号などが1つのトークンになる場合もあります。
ステップ3:文脈から次に適切なトークンを予測する
モデルは、現在の入力内容やそれまでに生成した文章を踏まえて、次に続く候補の確率分布を計算します。
そこから一定のルールに基づいて次のトークンが選択され、さらに次のトークンを予測する処理が繰り返されます。
この処理が非常に高速で繰り返されることで、私たちには自然な文章として見える回答が生成されます。
生成AIは必ず毎回「最も確率が高い言葉だけ」を選んでいるとは限りません。生成設定やモデルの仕組みに応じて複数の候補から選択されるため、同じ質問でも少し違う回答になることがあります。
AIは回答するとき、学習データを検索しているの?
通常の生成処理では、AIが学習データそのものを検索して該当ページを取り出しているわけではありません。
ここは非常に誤解されやすいポイントです。
モデルは学習によって形成されたパラメータと、現在与えられている文脈から回答を生成します。
一方、AIにWeb検索機能や社内データ検索などが組み込まれている場合は、回答時に外部情報を取得することがあります。
このように、外部情報を取得して生成AIの回答に利用する仕組みは「RAG(Retrieval-Augmented Generation:検索拡張生成)」などと呼ばれます。
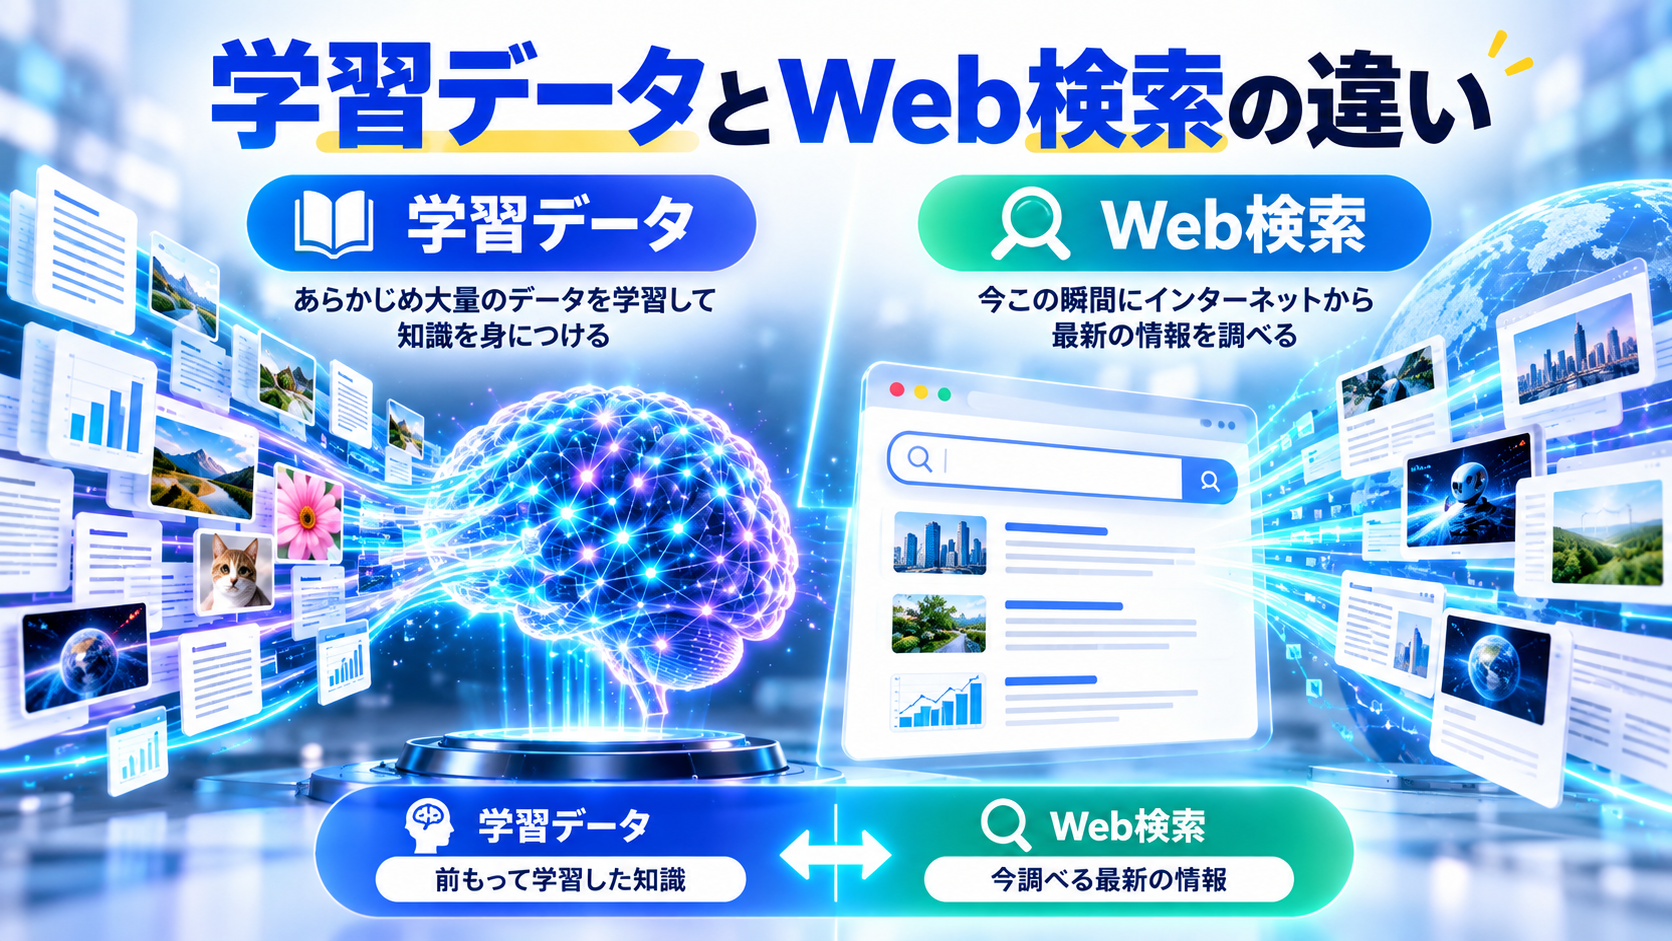
学習データとWeb検索は何が違う?
| 比較項目 | 学習データ | Web検索・外部検索 |
|---|---|---|
| 使われるタイミング | 主にモデル開発・学習時 | ユーザーへの回答時 |
| 目的 | 言語や知識のパターンをモデルに学習させる | 現在の情報や特定の資料を取得する |
| 情報の鮮度 | モデルによって異なる | 検索対象が更新されていれば最新情報を取得できる場合がある |
| 出典確認 | 個々の学習元を回答から特定できない場合が多い | 参照元が提示される場合がある |
例えば「今日発表されたニュース」を質問した場合、学習済みモデルだけでは最新情報を知らない可能性があります。
しかしWeb検索機能を利用できるAIなら、現在の情報を検索して回答に利用できます。
「AIが知っていること」と「AIが今その場で調べたこと」は別物と考えると分かりやすいでしょう。
AIは本当に内容を「理解」している?
AIが人間とまったく同じ意味で物事を理解している、と断定することはできません。
大規模言語モデルは、大量の学習によって言語・概念・画像などの非常に複雑な関係を処理できます。
そのため、文章の要約、推論、コード作成、画像分析など、人間から見ると「理解しているように見える」高度な処理が可能です。
しかし、人間の意識や経験とAI内部の計算処理は同じものではありません。
初心者がAIを安全に利用するうえでは、
と覚えておくことが重要です。
AIはなぜ間違った回答をするの?
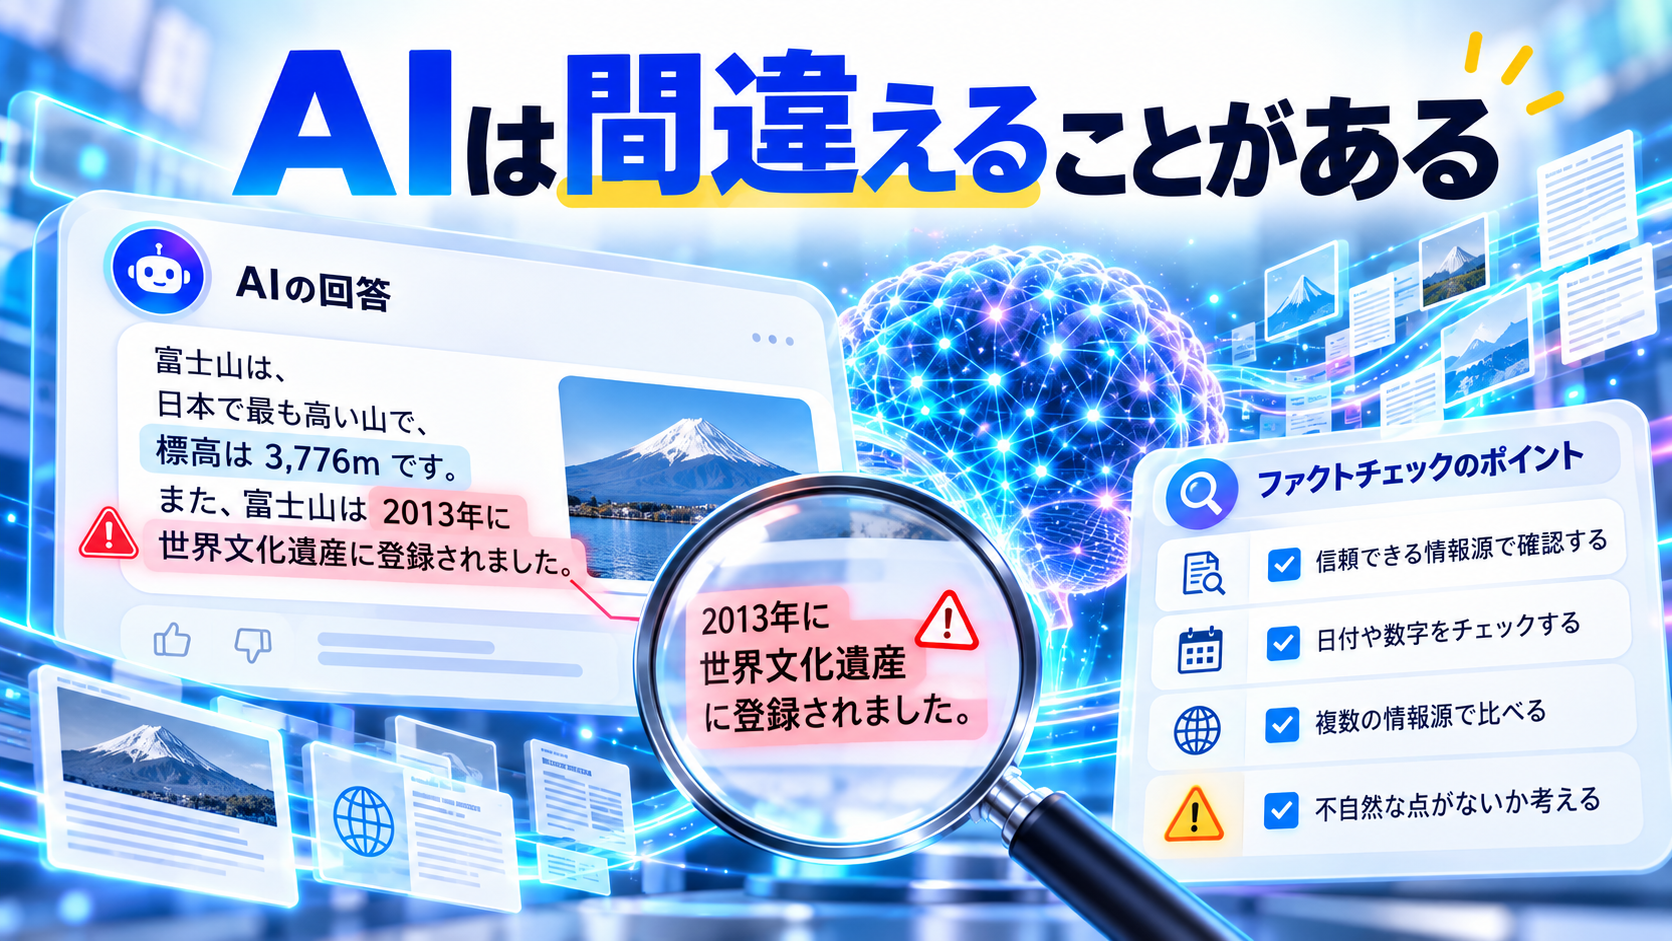
生成AIは「正しい文章をデータベースから取り出す仕組み」ではなく、文脈に応じて回答を生成する仕組みだからです。
そのため、自然で説得力のある文章でも、内容が事実と異なる場合があります。
このような現象は一般に「ハルシネーション」と呼ばれます。
例えば、
- 存在しない本や論文を紹介する
- 数字や日付を間違える
- 人物名や会社名を取り違える
- 最新情報を古い情報と混同する
- 根拠がない内容を断定する
ことがあります。
契約、法律、医療、税金、投資、会社の重要な意思決定などでは、AIの回答だけで判断せず、公式情報や専門家など信頼できる情報源を確認してください。
学習データが多ければAIは必ず賢くなる?
単純にデータ量を増やせば、必ずAIの性能が上がるわけではありません。
AIモデルの性能には、
- データの量
- データの質
- データの多様性
- 学習方法
- モデルの設計
- 計算資源
- 学習後の調整
- 評価方法
など多くの要素が関係します。
誤った情報や重複した情報、品質の低い情報を大量に追加すれば良いわけではありません。
現在のAI開発では、データの品質を整えたり、不要な情報を取り除いたり、AIが生成した合成データを利用したりする技術も重要になっています。
AIの学習データには偏りがある?
はい。学習データに偏りがある場合、その影響がAIの回答に現れる可能性があります。
例えば、インターネット上の情報には、
- 地域による情報量の差
- 言語による情報量の差
- 古い価値観
- 誤情報
- 特定の意見に偏った情報
などが含まれています。
AI開発企業はデータ処理や学習後の調整、安全性評価などによって問題を減らす取り組みを行っていますが、すべての偏りを完全になくせるとは限りません。
AIの学習データに個人情報は含まれる?
AIモデルやサービスによって異なりますが、公開情報などを利用する大規模な学習データには、個人に関する情報が含まれる可能性があります。
一方でAI開発企業は、個人情報を減らすためのフィルタリングや、安全性対策などを行っています。
また、ユーザーがAIサービスへ入力した会話内容がモデル改善に利用されるかどうかも、サービス・契約・設定によって異なります。
- パスワードを入力しない
- クレジットカード番号を入力しない
- 不要な個人情報を入力しない
- 会社の機密情報は社内ルールを確認してから利用する
- 利用サービスのデータ設定やプライバシーポリシーを確認する
AIの学習データと著作権はどう関係する?
生成AIの学習データと著作権については、国や地域の法律、利用方法、データの取得方法などによって扱いが異なります。
そのため、「公開されているデータならすべて自由にAI学習へ利用できる」「著作物は一切学習できない」と単純に説明することはできません。
また、
- 学習に利用する行為
- AIが生成したコンテンツ
- 生成物を商用利用する行為
も別々に考える必要があります。
著作権に関わる重要な判断では、最新の法令・ガイドライン・専門家の情報を確認してください。
AIの知識はいつの情報まで?
これはAIモデルやサービスによって異なるため、「ChatGPTは○年まで」「AIは○年まで」と一括りにはできません。
以前は「AIには知識のカットオフがあり、それ以降はまったく分からない」という説明がよく使われていました。
現在でもモデル自体の学習時期は重要ですが、AIサービスによってはWeb検索や外部データへのアクセスを利用できます。
そのため、最新情報を知りたいときは、
- Web検索機能が利用されているか
- 情報源が表示されているか
- 公式サイトの日付と一致しているか
を確認することが大切です。
AIに正確な回答をしてもらうための5つのコツ
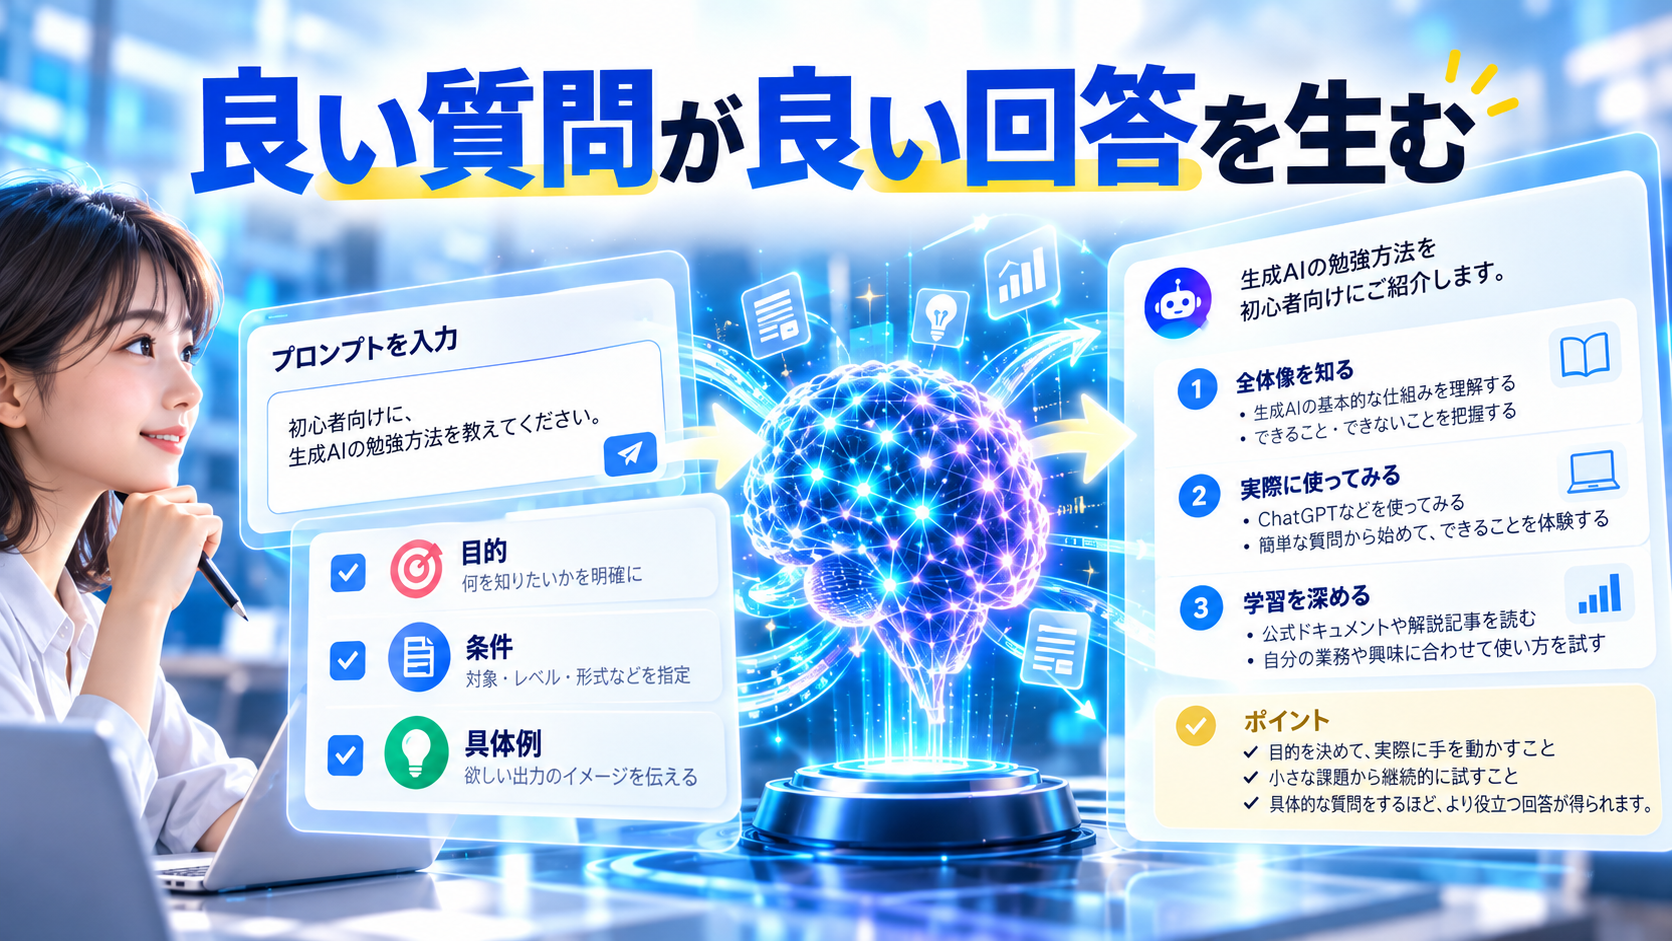
AIの性能だけでなく、質問の仕方や情報の与え方によって回答品質は大きく変わります。
1.質問を具体的にする
「AIについて教えて」より、
「生成AIが回答を作る仕組みを、高校生向けに専門用語を説明しながら500文字程度で教えて」
と伝える方が目的に合った回答を得やすくなります。
2.目的を伝える
ブログを書くのか、会社の資料を作るのか、勉強するのかによって必要な回答は変わります。
3.必要な資料を渡す
社内資料や自分で作った文章などをAIに扱わせる場合、利用しているサービスの情報管理ルールを確認したうえで必要な資料を提供すると、文脈に合った回答を得やすくなります。
4.最新情報は検索と組み合わせる
料金、法律、サービス仕様、製品情報、ニュースなどは変化します。
最新情報が必要な場合は、公式情報やWeb検索を確認しましょう。
5.重要な情報は必ず確認する
AIが自信満々に答えていても、内容が正しいとは限りません。
数字、固有名詞、引用、法律、医療情報などは特に確認する習慣を持つことが大切です。
AIの学習データについてよくある質問
Q1.AIの回答はどこから来ているのですか?
AIの回答は、学習によって形成されたモデル、ユーザーが入力した内容、そして利用可能な場合はWeb検索やファイルなどの外部情報をもとに生成されます。
質問されるたびに学習データそのものを検索して文章をコピーしているわけではありません。
Q2.ChatGPTはインターネット全体を学習しているのですか?
「インターネット全体を学習している」と考えるのは正確ではありません。
AIモデルの開発には公開情報、利用許諾を得た情報、人間が作成したデータなど複数の情報源が利用される場合があります。具体的な内容はモデルや開発企業によって異なります。
Q3.AIは学習した文章をそのまま記憶していますか?
基本的には、学習データを検索可能な文章データベースとしてそのまま保存する仕組みではありません。
学習によってデータのパターンや関係性がモデル内部のパラメータへ反映され、それを利用して回答が生成されます。
Q4.AIの回答は常に正しいですか?
いいえ。AIは間違った情報を生成することがあります。
自然で説得力のある文章でも内容が誤っていることがあるため、重要な情報は公式情報などで確認してください。
Q5.ChatGPTに入力した内容はすべて学習に使われますか?
必ずしもそうではありません。
ユーザーの入力内容をモデル改善に利用するかどうかは、利用しているサービス、契約内容、アカウント設定などによって異なります。最新の設定や利用規約を確認してください。
Q6.検索機能を使えばAIの回答は必ず正しくなりますか?
いいえ。検索を使っても誤解、情報源の選択ミス、古い情報の参照などが起こる可能性があります。
検索機能は最新性や根拠確認に役立ちますが、重要な情報については参照元そのものを確認することが大切です。
AIの学習データを理解すると生成AIを使いやすくなる
AIをうまく使うために、難しい数学やプログラミングを理解する必要はありません。
まず覚えておきたいのは、次の4点です。
- AIは大量のデータからパターンを学習する
- 学習データそのものを毎回答えとして検索しているわけではない
- 回答時には入力内容や、場合によっては検索・ファイル・外部ツールも利用する
- AIの回答は間違う可能性があるため、重要な情報は確認する
この基本を理解しておくだけでも、AIの回答を「絶対に正しい情報」と考えるのではなく、「非常に便利な情報処理・生成ツール」として適切に活用しやすくなります。
生成AIはこれからさらに進化していきます。
だからこそ、「どのAIが一番賢いか」だけではなく、AIがどのような仕組みで情報を扱い、どの部分を人間が確認する必要があるのかを理解しておくことが大切です。
まとめ|AIの学習データは「回答の元になる巨大な検索データベース」ではない
AIの学習データとは、AIが言葉・画像・音声などのパターンを学習するために利用される情報です。
生成AIは学習データをそのまま保存して、ユーザーから質問されるたびに該当する文章を検索しているわけではありません。
大量のデータから学んだパターンがモデル内部のパラメータとして反映され、それを使って回答を生成します。
さらに現在のAIサービスでは、Web検索、ファイル、外部サービスなどを組み合わせて回答するケースも増えています。
そのためAIを理解するときは、
- モデルが事前に学習した情報
- 現在の会話で与えた情報
- 検索などで取得した外部情報
を分けて考えることが重要です。
AIはとても便利ですが、回答が必ず正しいわけではありません。
AIに任せる部分と、人間が確認する部分をうまく分けることが、生成AIを安全かつ効果的に使うコツです。
注意書き
本記事は2026年10月7日時点で確認できる情報をもとに、AI初心者向けに仕組みを簡略化して解説しています。
生成AIのモデル、学習方法、検索機能、プライバシー設定、利用規約などは今後変更される可能性があります。
特定のAIサービスについて最新情報を確認する場合は、各サービスを提供する企業の公式サイト、公式ヘルプ、プライバシーポリシー、利用規約をご確認ください。
また、AIが生成した回答は正確性・最新性・完全性が保証されるものではありません。
法律、税務、医療、投資その他の重要な判断では、AIの回答だけで判断せず、公的機関、一次情報、資格を持つ専門家など信頼できる情報源をご確認ください。

コメント