「Pythonを使えば株価を予測できるの?」「LSTMを使うと本当に予測精度は上がる?」 と気になっている方も多いのではないでしょうか。
Pythonには、株価データの取得・分析・機械学習・ディープラーニングまでを 一通り実行できるライブラリがそろっています。 そのため、初心者でも実際の市場データを使った 時系列予測モデルを比較的簡単に作成できます。
ただし、最初に知っておきたい重要なポイントがあります。
この記事では、Pythonで株価データを取得するところから、 LSTMモデルの構築、評価、精度を改善するときに確認したいポイントまで、 初心者向けに順番に解説します。
株価予測とは?AIで未来の株価はわかるのか
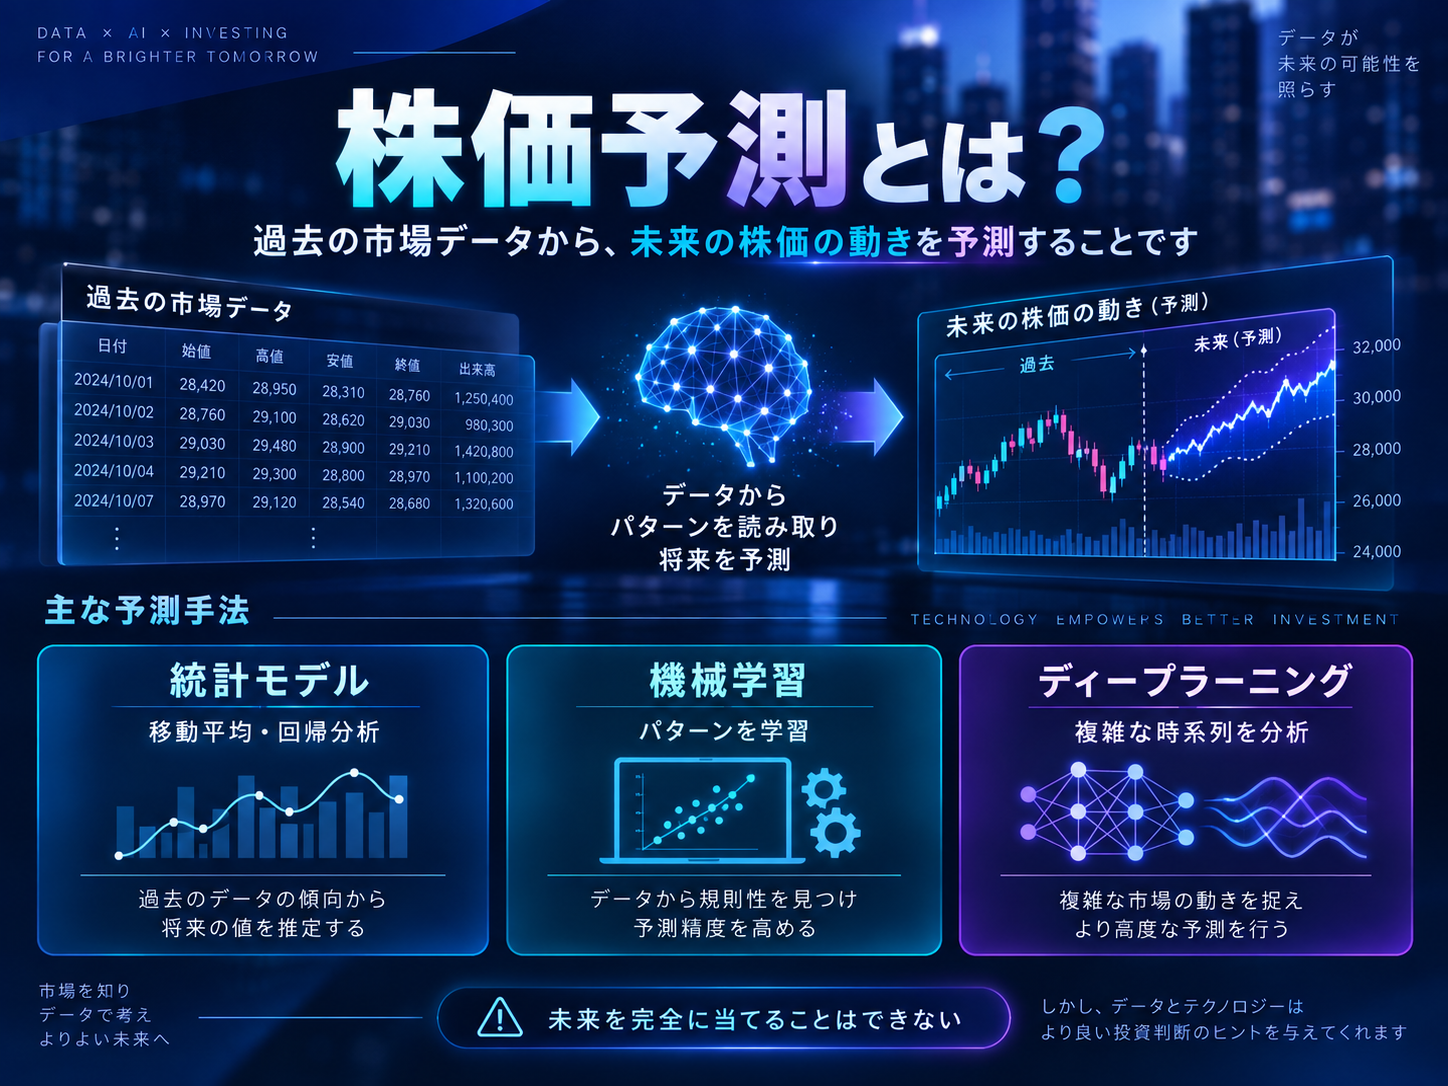
株価予測とは、過去の株価、出来高、テクニカル指標、 経済データなどを利用して、将来の値動きを推定する取り組みです。
代表的な方法は、大きく次の3種類に分けられます。
| 方法 | 代表例 | 特徴 |
|---|---|---|
| 統計モデル | 移動平均・回帰分析・ARIMAなど | 比較的仕組みを理解しやすい |
| 機械学習 | Random Forest・XGBoostなど | 複数の特徴量からパターンを学習できる |
| ディープラーニング | LSTM・GRU・Transformerなど | 複雑な時系列パターンを学習できる |
ここで注意したいのが、 複雑なAIを使えば必ず精度が高くなるわけではない という点です。
株式市場には企業業績、金利、為替、政策、地政学リスク、 投資家心理、突発的なニュースなど、 過去の株価だけでは説明できない要因が大量に存在します。
そのため実務では、 「AIモデルを作ること」よりも 適切に検証し、本当に予測力があるのか確認すること のほうが重要です。
株価予測にPythonが向いている理由
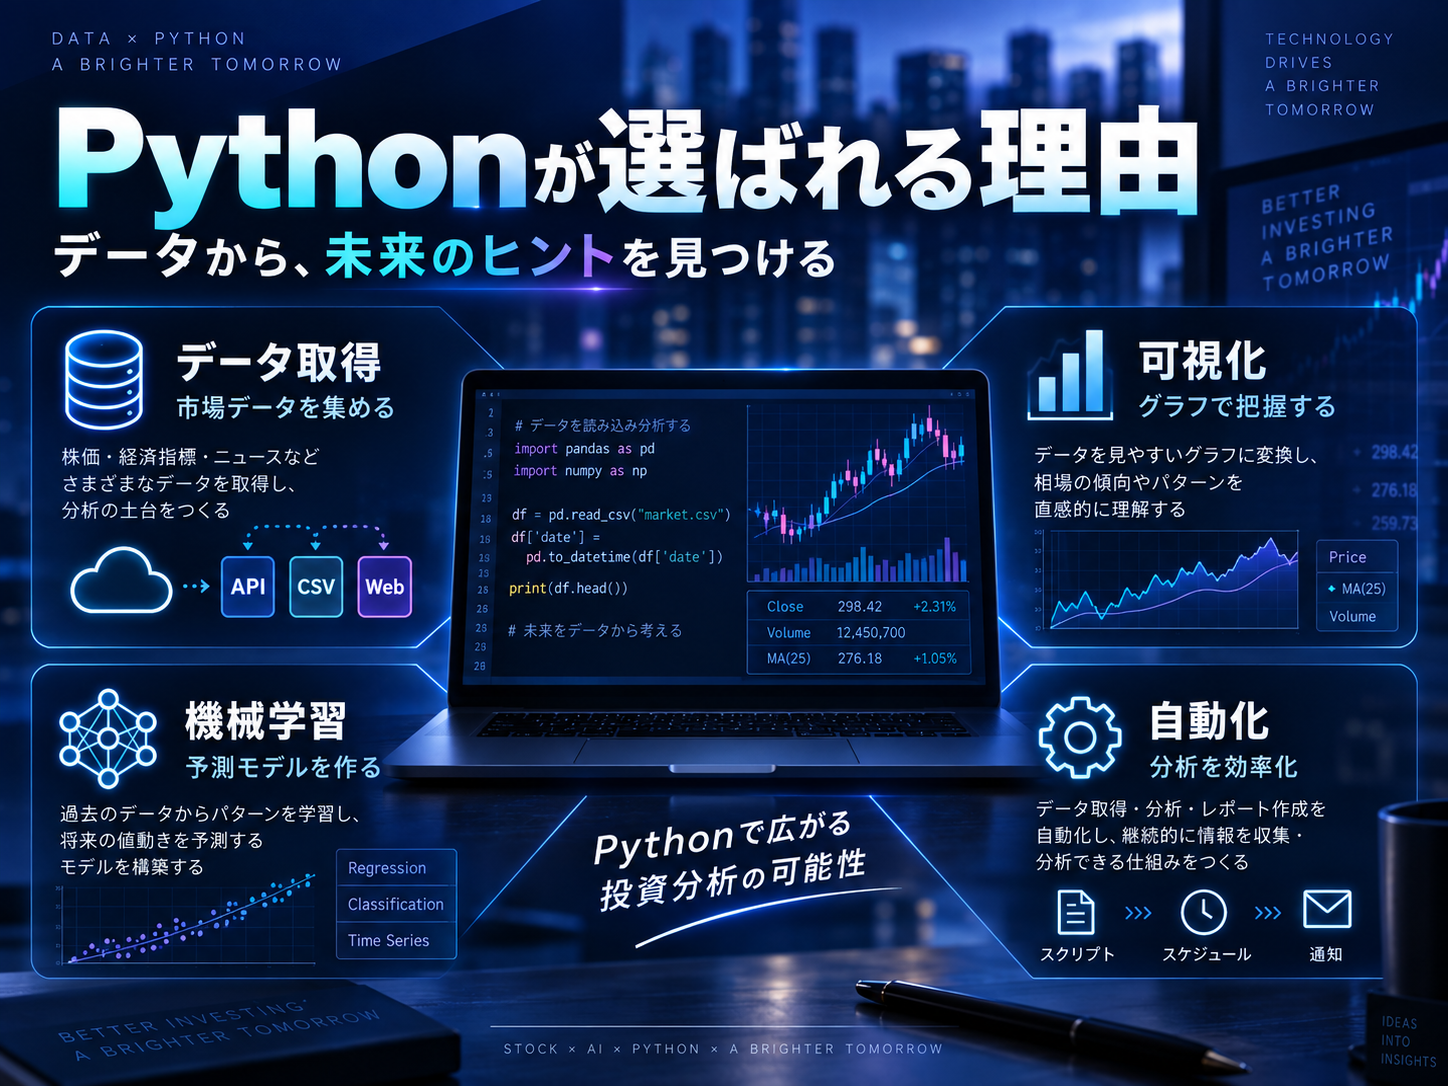
株価予測やAI開発でPythonが広く使われている理由は、 データ分析から機械学習まで豊富なライブラリがそろっているからです。
- 株価データを取得できる
- 大量の時系列データを処理できる
- グラフを簡単に作成できる
- 機械学習モデルを実装できる
- LSTMなどのニューラルネットワークを構築できる
- バックテストや自動分析へ発展させやすい
PythonやAIそのものを先に理解したい方は、 当サイトの AI基礎技術を初心者でも理解できる完全ガイド もあわせて参考にしてください。
Pythonで株価予測するときに使う主なライブラリ
| ライブラリ | 主な用途 |
|---|---|
| pandas | 表形式データの整理・加工 |
| NumPy | 数値計算・配列処理 |
| yfinance | 株価・出来高などの市場データ取得 |
| Matplotlib | 株価や予測結果のグラフ化 |
| scikit-learn | 前処理・機械学習・評価指標 |
| TensorFlow / Keras | LSTMなどのディープラーニング |
| PyTorch | ニューラルネットワーク・研究開発 |
まず必要なパッケージをインストールします。
pip install yfinance pandas numpy matplotlib scikit-learn tensorflowGoogle Colabを利用する場合は、 TensorFlowなど一部ライブラリがすでに利用できる場合があります。
yfinanceを使って株価データを取得してみよう

Pythonでは、yfinanceを利用すると Yahoo Finance由来の市場データを比較的簡単に取得できます。
今回は米Appleのティッカーシンボル AAPLを例にします。
import yfinance as yf
import pandas as pd

stock = yf.download(
    "AAPL",
    period="10y",
    interval="1d",
    auto_adjust=True,
    multi_level_index=False,
    progress=False
)

print(stock.head())
print(stock.tail())
データには主に次の情報が含まれます。
- Open:始値
- High:高値
- Low:安値
- Close:終値
- Volume:出来高
まずは終値をグラフ化してみましょう。
import matplotlib.pyplot as plt

plt.figure(figsize=(12, 6))
plt.plot(stock.index, stock["Close"])
plt.title("AAPL Stock Price")
plt.xlabel("Date")
plt.ylabel("Price")
plt.grid(True)
plt.show()
これだけでもPythonを使った基本的な株価分析を体験できます。
LSTMとは?なぜ時系列予測に使われるのか
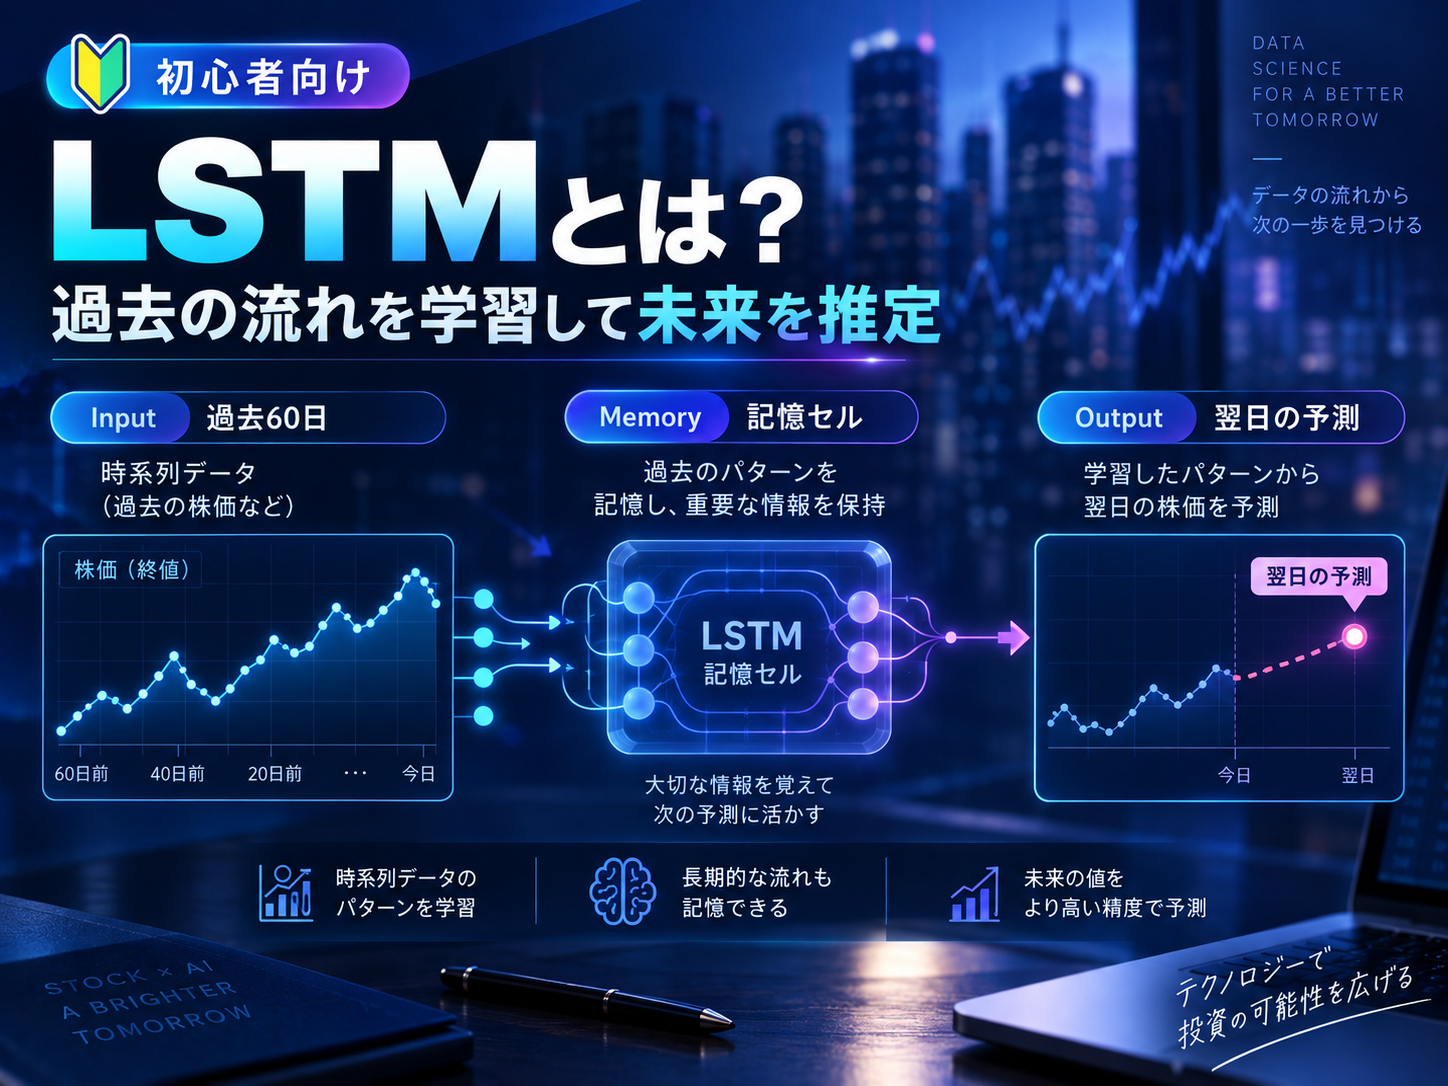
LSTM(Long Short-Term Memory)は、 RNN(Recurrent Neural Network:再帰型ニューラルネットワーク)の一種です。
通常のニューラルネットワークと異なり、 過去の時系列情報を内部状態として扱える仕組みを持っています。
例えば株価の場合、
- 昨日の価格
- 1週間前の価格
- 過去60営業日の値動き
など連続した情報を入力し、 次の時点の値を推定するモデルを構築できます。
ただし「株価は時系列だからLSTMが最強」という意味ではありません。 単純なベースラインモデルや Random Forest、XGBoostなどがLSTMを上回るケースもあります。
大切なのは、 複数モデルを同じ条件で比較することです。
PythonでLSTM株価予測モデルを作ってみよう
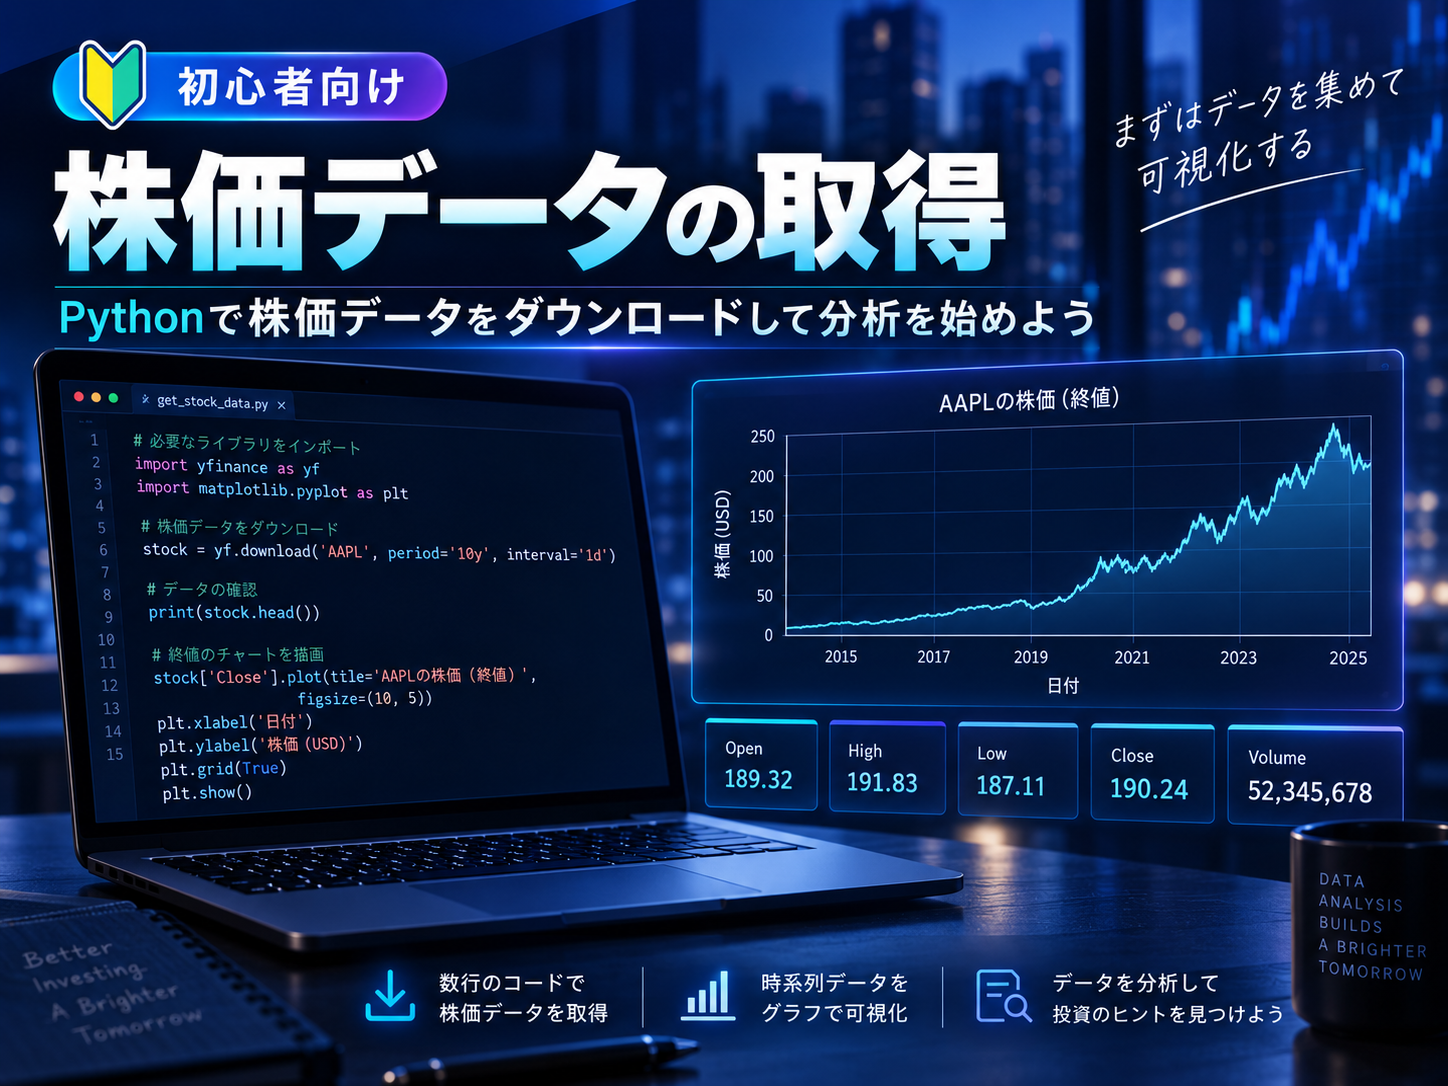
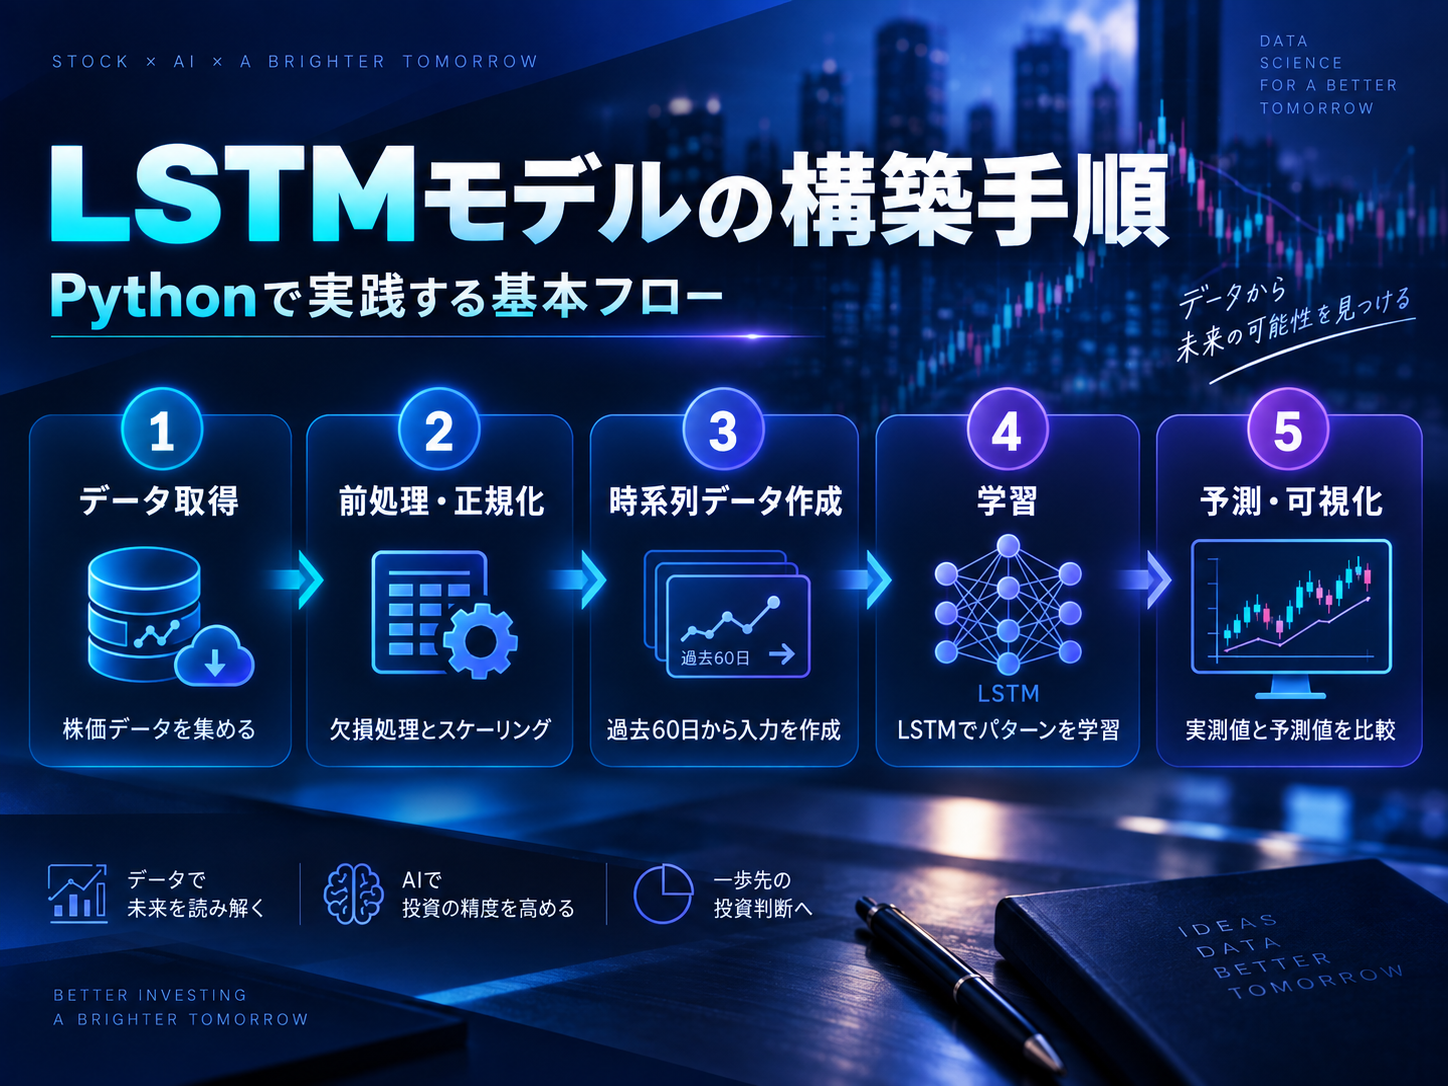
ここから実際に、 「過去60営業日の終値から翌営業日の終値を推定する」 シンプルなLSTMモデルを作ります。
STEP1:データを訓練用とテスト用に分ける
import numpy as np
from sklearn.preprocessing import MinMaxScaler

prices = stock[["Close"]].dropna().values

train_size = int(len(prices) * 0.8)

train_data = prices[:train_size]
test_data = prices[train_size:]
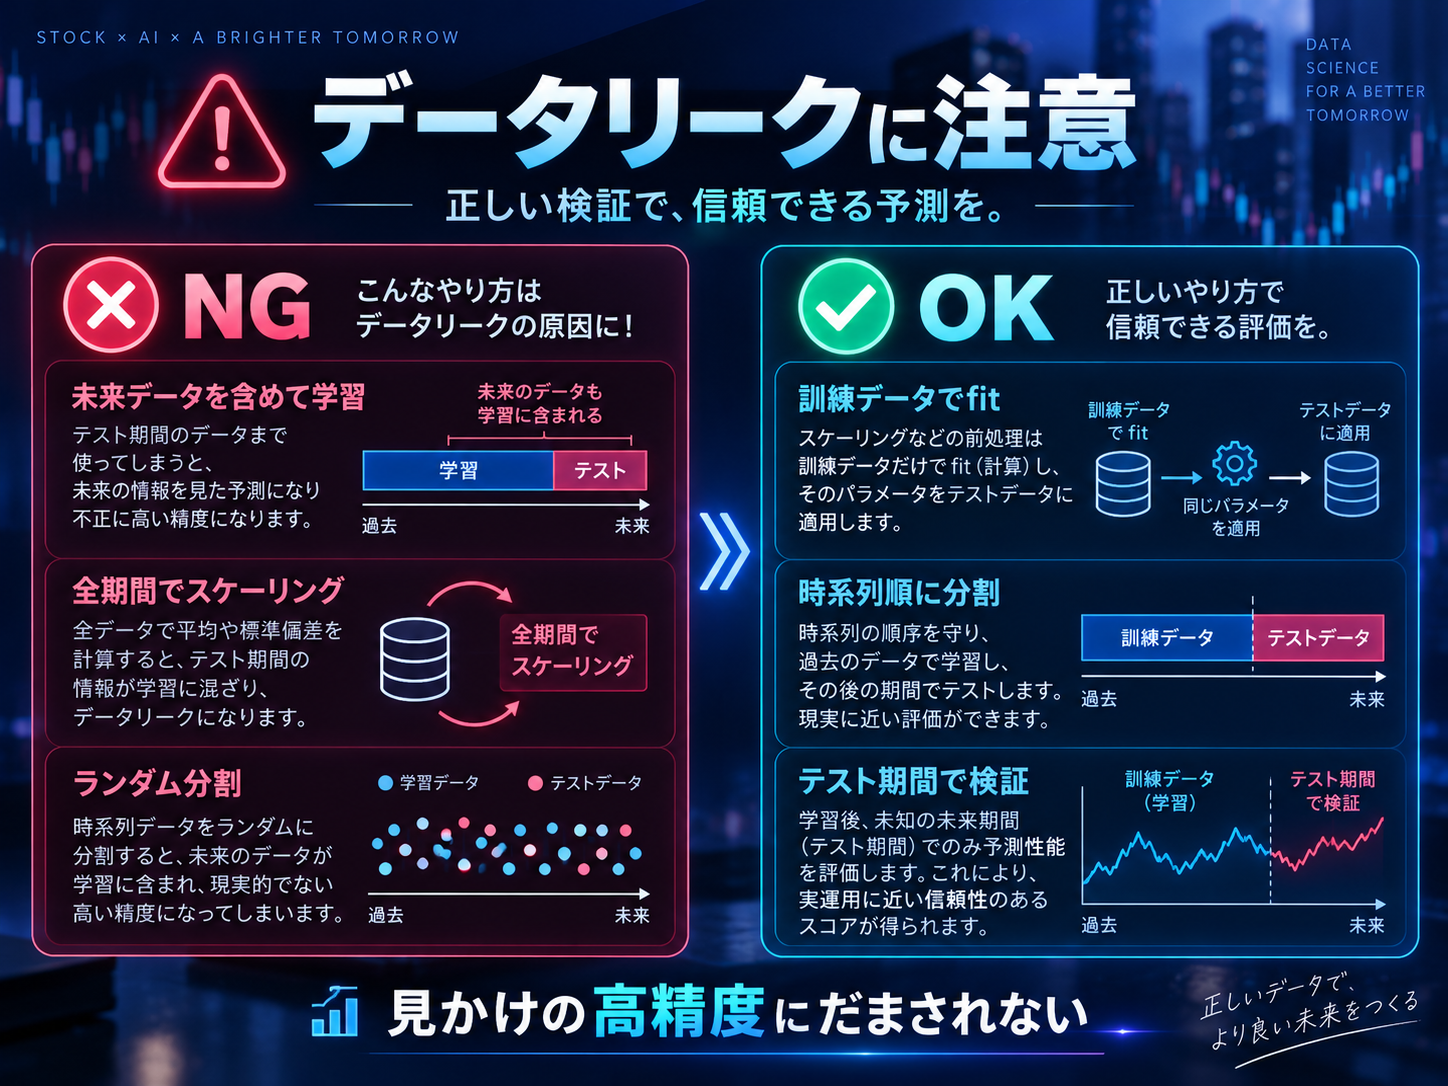
株価は時系列データなので、 通常の機械学習のようにランダムにシャッフルしてはいけません。
過去を訓練データ、 それより未来をテストデータとして扱います。
STEP2:データを0〜1にスケーリングする
scaler = MinMaxScaler(feature_range=(0, 1))

scaler.fit(train_data)

scaled_train = scaler.transform(train_data)
scaled_test = scaler.transform(test_data)
ここは非常に重要です。
Scalerは訓練データだけでfitします。 テストデータまで含めてfitしてしまうと、 将来の情報が学習時に混入する 「データリーク」が発生する可能性があります。
STEP3:60日分の時系列データを作る
LOOKBACK = 60

def create_sequences(data, lookback=60):
    X, y = [], []

    for i in range(lookback, len(data)):
        X.append(data[i-lookback:i])
        y.append(data[i])

    return np.array(X), np.array(y)

X_train, y_train = create_sequences(scaled_train, LOOKBACK)

combined_test = np.concatenate([
    scaled_train[-LOOKBACK:],
    scaled_test
])

X_test, y_test = create_sequences(combined_test, LOOKBACK)

print(X_train.shape)
print(X_test.shape)
LSTMでは入力を基本的に [サンプル数, 時間ステップ, 特徴量] の形にします。
STEP4:LSTMモデルを構築する
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Input, LSTM, Dense, Dropout

tf.keras.utils.set_random_seed(42)

model = Sequential([
    Input(shape=(LOOKBACK, 1)),

    LSTM(
        64,
        return_sequences=True
    ),

    Dropout(0.2),

    LSTM(
        32,
        return_sequences=False
    ),

    Dropout(0.2),

    Dense(16, activation="relu"),
    Dense(1)
])

model.compile(
    optimizer="adam",
    loss="mean_squared_error",
    metrics=["mean_absolute_error"]
)

model.summary()
STEP5:モデルを学習する
from tensorflow.keras.callbacks import EarlyStopping

early_stopping = EarlyStopping(
    monitor="val_loss",
    patience=10,
    restore_best_weights=True
)

history = model.fit(
    X_train,
    y_train,
    validation_split=0.2,
    epochs=100,
    batch_size=32,
    shuffle=False,
    callbacks=[early_stopping],
    verbose=1
)EarlyStoppingを使うことで、 検証データの性能が改善しなくなった段階で学習を終了できます。
また時系列データでは、 順序を維持するため shuffle=False としています。
STEP6:テストデータを予測する
pred_scaled = model.predict(X_test)

predicted_prices = scaler.inverse_transform(pred_scaled)
actual_prices = scaler.inverse_transform(y_test)
STEP7:実測値と予測値をグラフで比較する
plt.figure(figsize=(12, 6))

plt.plot(
    stock.index[train_size:],
    actual_prices,
    label="Actual"
)

plt.plot(
    stock.index[train_size:],
    predicted_prices,
    label="Predicted"
)

plt.title("AAPL LSTM Prediction")
plt.xlabel("Date")
plt.ylabel("Price")
plt.legend()
plt.grid(True)
plt.show()
実際の価格と予測価格がどの程度近いかを視覚的に確認できます。
「グラフが似ている」だけではダメ|予測精度を数値で評価する
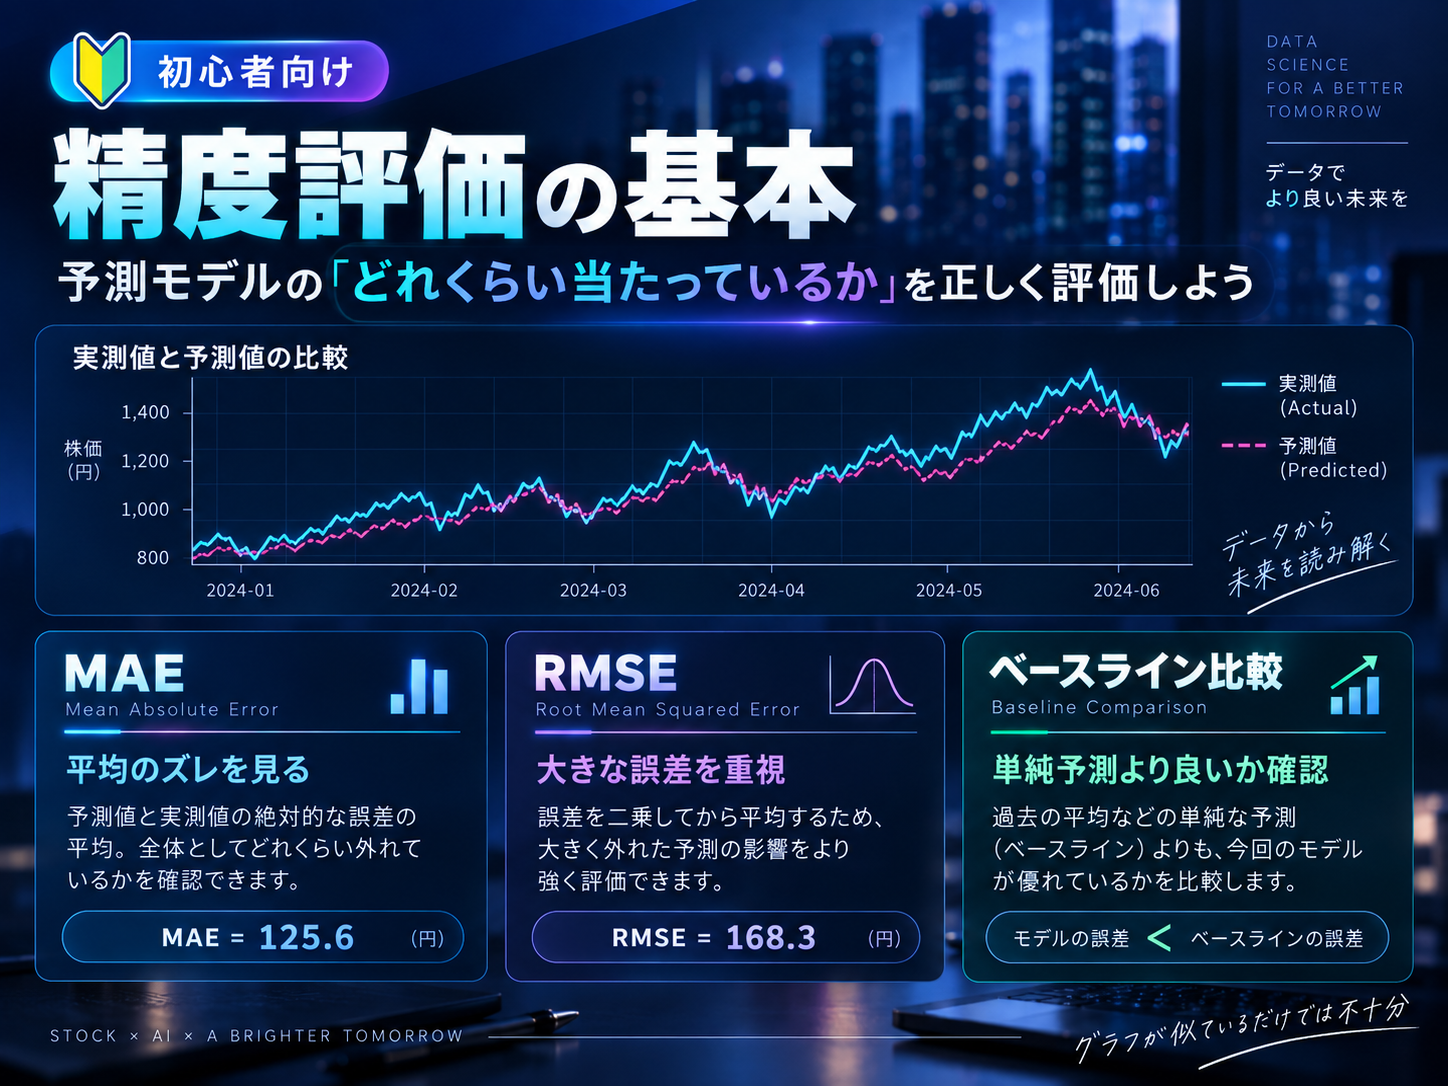
AI株価予測でありがちな失敗が、 実測値と予測値のグラフだけを見て 「かなり当たっている」と判断してしまうことです。
モデルは必ず評価指標を使って確認しましょう。
from sklearn.metrics import mean_absolute_error
from sklearn.metrics import mean_squared_error

mae = mean_absolute_error(
    actual_prices,
    predicted_prices
)

rmse = np.sqrt(
    mean_squared_error(
        actual_prices,
        predicted_prices
    )
)

print(f"MAE: {mae:.2f}")
print(f"RMSE: {rmse:.2f}")
MAEとは
MAE(Mean Absolute Error)は、 実際の値と予測値の差を平均した指標です。
例えばMAEが3ドルなら、 平均すると予測価格が実際の価格から 約3ドルずれているというイメージです。
RMSEとは
RMSE(Root Mean Squared Error)は、 大きな予測ミスをより強く評価する指標です。
AIモデルより重要?必ずベースラインと比較する
LSTMを作っただけでは、 そのモデルに本当に価値があるか判断できません。
株価予測では例えば、
「明日の株価は今日と同じ」
と予測する非常に単純なモデルでも、 意外と強いベースラインになることがあります。
baseline = prices[train_size - 1:-1]

baseline_mae = mean_absolute_error(
    actual_prices.flatten(),
    baseline.flatten()
)

print(f"Baseline MAE: {baseline_mae:.2f}")
print(f"LSTM MAE: {mae:.2f}")
LSTMの誤差が単純なベースラインより悪ければ、 複雑なAIモデルを使う意味はあまりありません。
LSTM株価予測の精度を改善する7つの方法
1.終値だけで予測しない
終値1つだけでは利用できる情報が限られます。
例えば次のデータを特徴量として追加できます。
- 始値
- 高値
- 安値
- 出来高
- 日次リターン
- 移動平均
- ボラティリティ
2.株価そのものではなくリターンを予測する
株価そのものには長期的なトレンドが含まれるため、 モデルが「上昇トレンドを追いかけているだけ」 になる場合があります。
そこで日次リターンを利用する方法があります。
stock["Return"] = stock["Close"].pct_change()3.テクニカル指標を追加する
stock["MA5"] = stock["Close"].rolling(5).mean()
stock["MA20"] = stock["Close"].rolling(20).mean()

stock["Volatility20"] = (
    stock["Close"]
    .pct_change()
    .rolling(20)
    .std()
)

stock = stock.dropna()
ただし特徴量を増やせば必ず精度が向上するわけではありません。 不要な特徴量は逆に過学習の原因になることがあります。
4.価格だけでなく「上がる・下がる」を予測する
投資の目的によっては、 明日の終値を1円単位で予測するより、
- 上昇する
- 下落する
という方向性を分類問題として扱うほうが適している場合があります。
5.LSTM以外のモデルとも比較する
比較候補としては次のようなものがあります。
- Linear Regression
- Random Forest
- Gradient Boosting
- XGBoost
- LightGBM
- GRU
- 1D-CNN
- Transformer系時系列モデル
株価予測では、 最も複雑なモデルが最も優秀とは限りません。
6.時系列クロスバリデーションを行う
1回のtrain/test分割だけでは、 特定期間だけ偶然うまく予測できている可能性があります。
そこで、 TimeSeriesSplit などを利用した時系列クロスバリデーションが役立ちます。
from sklearn.model_selection import TimeSeriesSplit

tscv = TimeSeriesSplit(
    n_splits=5
)

for train_index, test_index in tscv.split(stock):
    print(
        "TRAIN:",
        train_index[0],
        "-",
        train_index[-1]
    )

    print(
        "TEST:",
        test_index[0],
        "-",
        test_index[-1]
    )
7.データリークを徹底的に防ぐ
株価AIで高い精度が出た場合に、 最初に疑うべきものの一つがデータリークです。
特に注意したいのは次のケースです。
- 全期間を使ってScalerをfitしている
- 未来の株価から計算した特徴量が混入している
- 時系列データをランダムに分割している
- テスト期間を何度も見ながらモデルを調整している
AIモデルの精度そのものより、 検証方法が正しいか を先に確認しましょう。
株価予測モデルにはバックテストが必要
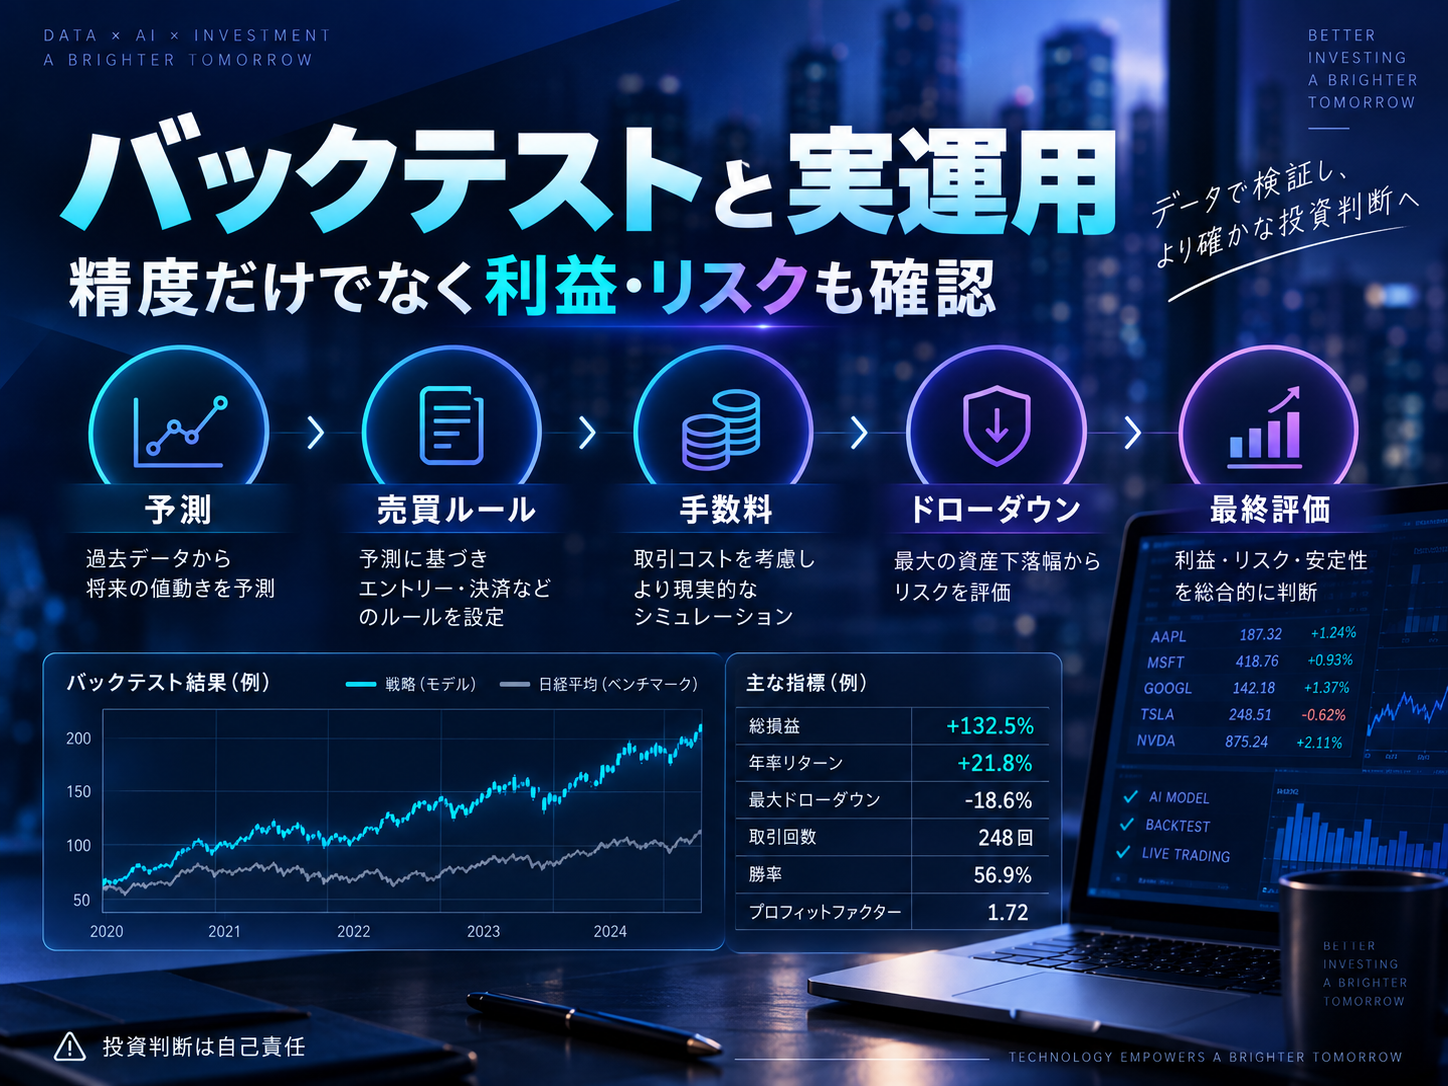
MAEやRMSEが低くても、 それだけで投資戦略として利益が出るとは限りません。
実際の投資を想定するなら、 モデルの予測を売買ルールへ変換して バックテストする必要があります。
例えば、
- 翌日上昇予測 → 買う
- 翌日下落予測 → 保有しない
といったルールを過去データに適用します。
さらに、
- 取引手数料
- スプレッド
- スリッページ
- 税金
- 最大ドローダウン
- 市場環境の変化
なども考慮する必要があります。
「予測精度が高いモデル」と 「利益を出せる投資戦略」は、 同じものではありません。
株価予測でニュースや企業情報を使う方法
さらに高度なモデルを作る場合は、 株価以外の情報も組み合わせられます。
- 決算情報
- 企業業績
- 金利
- 為替
- 経済指標
- ニュース
- SNS投稿
- 決算説明資料
特に近年は自然言語処理や生成AIを利用して、 ニュースのセンチメントを数値化して 時系列モデルへ組み込む研究も行われています。
ただし、 「ChatGPTに銘柄を聞けば勝てる」 「AIが自動で儲かる株を教えてくれる」 といった考え方は避けるべきです。
AIは分析を補助するツールであり、 将来の市場を保証するものではありません。
株価予測AIのメリット
- 大量のデータを処理できる: 人間では処理しきれない量のデータを分析できます。
- 分析を自動化しやすい: データ取得から予測までPythonで自動化できます。
- 複数要因を組み合わせられる: 価格・出来高・経済データなどを同時に扱えます。
- Python・AI学習の題材として優秀: データ分析、可視化、機械学習、時系列予測をまとめて学べます。
株価予測AIのデメリット・注意点
- 未来を確実に予測できない: 突発的なニュースや市場急変は予測困難です。
- 過学習しやすい: 過去データでは優秀でも未来では通用しないことがあります。
- データリークが起こりやすい: 検証方法を間違えると実際以上に高い精度が表示されます。
- 市場環境が変化する: 過去に有効だったパターンが今後も続く保証はありません。
- 取引コストを考慮する必要がある: 理論上の収益と実際の収益は異なります。
初心者はどこから学べばいい?おすすめロードマップ
- Python基礎
変数、条件分岐、繰り返し、関数を学ぶ。 - NumPy・pandas
データ操作に慣れる。 - Matplotlib
データをグラフ化する。 - scikit-learn
機械学習と評価方法を学ぶ。 - 時系列分析
時系列分割・特徴量・バックテストを学ぶ。 - TensorFlow / Keras
LSTMなどのディープラーニングへ進む。
最初から高度なAIモデルを作る必要はありません。
「株価を取得する → グラフを描く → 特徴量を作る → 簡単なモデルを試す」 という順番で進めると理解しやすくなります。
AI・機械学習そのものを基礎から学びたい方は、 機械学習からディープラーニングまで解説したAI基礎技術ガイド もおすすめです。
Pythonによる株価予測でよくある質問
Q1.Python初心者でも株価予測はできますか?
はい。yfinanceやpandasを利用すれば、 初心者でも株価データの取得やグラフ化から始められます。 まずはディープラーニングより、 Pythonとデータ分析の基礎を理解するのがおすすめです。
Q2.LSTMを使えば株価予測の精度は上がりますか?
必ず上がるわけではありません。 データ、特徴量、対象銘柄、予測期間、市場環境によって結果は変わります。 単純なベースラインや他の機械学習モデルと比較してください。
Q3.株価予測AIで100%当てることはできますか?
できません。 市場には予測不能なニュースや政策変更、企業イベントなどが存在します。 AIによる予測は確率的な分析結果として考える必要があります。
Q4.日本株もPythonで取得できますか?
データ提供サービス側で対応しているティッカーであれば取得できます。 ただしデータ提供条件やティッカー形式はサービスごとに異なるため、 利用時点の仕様を確認してください。
Q5.LSTMとTransformerならどちらがおすすめですか?
初心者が時系列ディープラーニングを学ぶ目的なら、 まずLSTMがおすすめです。 Transformer系モデルは強力ですが構造が複雑で、 必ずLSTMより精度が高くなるわけではありません。
Q6.ChatGPTだけで株価予測できますか?
ChatGPTはPythonコードの作成、分析手法の整理、 データ処理の補助などには活用できますが、 将来の株価を保証できるサービスではありません。 投資判断をAIの回答だけに依存しないようにしましょう。
まとめ|Python株価予測は「当てる」より「正しく検証する」ことが重要
Pythonを使えば、 株価データの取得から機械学習・ディープラーニングまで 一連の分析を行えます。
特にLSTMは、 時系列データを扱うニューラルネットワークを学ぶ教材として非常に面白いテーマです。
一方で、 「ディープラーニングを使えば簡単に株価を当てられる」 わけではありません。
重要なのは、
- 未来情報を学習データへ混ぜない
- 時系列順に訓練・テストを分割する
- ベースラインと比較する
- MAE・RMSEなどで評価する
- 複数期間で検証する
- バックテストを行う
- 過学習を疑う
といった検証の考え方です。
株価予測は、 Python、pandas、機械学習、ディープラーニング、 データ分析をまとめて学べる非常に良い実践テーマです。
まずは今回紹介したコードを実行し、 銘柄や期間、特徴量、モデルを少しずつ変えながら 「どの条件なら結果がどう変わるのか」を試してみてください。
AIを基礎から体系的に学びたい方は、 AI基礎技術を初心者でも理解できる完全ガイド もあわせてご覧ください。


コメント